批量转双层PDF v4.1.2 中文绿色版下载(扫描件转可搜索PDF)
扫描出来的 PDF 就是一张图:字看得见,搜不到、复制不了、也没法选中。双层 PDF 的做法是在图像底下垫一层看不见的文字,外观还是原扫描件的样子,但全文检索、复制粘贴都能用。这个工具负责把一整个文件夹的扫描件批量转成这种格式。
截图预览
功能亮点
- 批量处理:一次加入多份 PDF 甚至整个子目录,排进队列统一跑完。
- 倾斜与方向校正:扫描时放歪、倒置的页面自动摆正,识别准确率跟着上来。
- 空白页清理:识别过程中顺手检出空白页并去掉,卷宗体积能小一截。
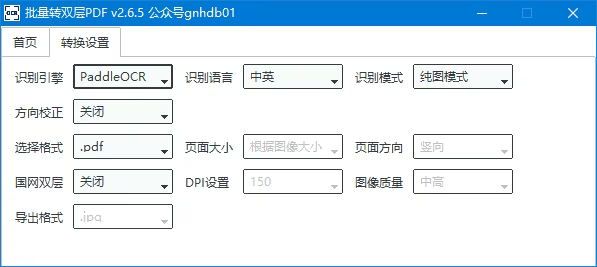
- 多语种识别:按资料的语言选识别语种,中文、英文以及混排文档都覆盖。
- 精度档位可调:速度与准确率之间自己权衡,急用的资料先跑快档。
- 输出目录分开:成品另存到指定路径,源文件不会被覆盖。
- 文本层可选:文字层的显示与否、透明度可调,不影响原始观感。
性能优化
识别运算全部在本机完成,不联网、不上传,涉密档案也能放心跑。任务按队列顺序执行,单个文件损坏会跳过继续下一个,不会因为一份坏文件把整批任务卡死。机器性能主要吃 CPU,批量处理时把其他重负载程序关掉会快不少。
使用说明
绿色版解压后直接运行。先把源目录加进列表,选好识别语种和精度档位,指定输出位置,点开始即可。跑完看日志,标记失败的文件单独重跑一次。资料多的时候建议分批:一次放几十份,跑完检查一下识别质量,再继续下一批。
常见问题
转换后还是搜不到字?
检查识别语种是否选对,以及源件是不是分辨率太低。字迹模糊的扫描件识别率会明显下降。
输出文件比原来大很多?
双层 PDF 多了一层文字数据,体积上升正常。开启空白页清理、适当降低图像质量可以压回来一些。
能把 OFD 也一起处理吗?
支持 OFD 模块。混在不同目录里一起提交,程序会按格式分别处理。
更新日志
v4.1.1
- 更新 OFD 模块,优化输出文件体积
- 左侧二级菜单增加选中状态
- 修复部分引擎选项中的错误名称
下载地址
免责声明
本站所提供的软件、系统镜像、教程等内容均整理自网络或公开渠道,仅供个人学习、研究与技术交流使用,请勿用于商业用途。
所有资源的著作权、商标权等合法权益均归原开发者或发行方所有。若本站内容不慎侵犯您的权益,请与站长联系,我们将在核实后及时删除。
用户在使用本站资源过程中所产生的一切后果(包括但不限于系统故障、数据丢失、安全风险等)均由使用者自行承担,本站不承担任何直接或间接责任。
下载资源前请仔细阅读相关说明,并建议在虚拟机或测试环境中先行验证,谨慎操作。


